viernes, 20 de febrero de 2015

Enlazando el callejero de Zaragoza con datos.bne.es (4/4)

Este es el cuarto y último del conjunto de posts sobre el proceso de enlazado del callejero de Zaragoza con datos.bne.es. Ahora vamos a lanzar un proceso de crowdsourcing para validar los 81927 enlaces potenciales que hemos encontrado con datos de la Biblioteca Nacional (http://datos.bne.es/) en el post anterior.

Lanzando un proyecto de crowdsourcing para refinar los resultados obtenidos

¿Por qué necesitamos utilizar una herramienta de crowdsourcing? Pues porque la cantidad de datos que tenemos que validar es tan grande que no tenemos más remedio que utilizar la fuerza de la gente para realizar este tipo de tarea. Vamos a dividir el proceso en lo que se denominan "micro-tareas", donde cada persona va a tener que comprobar un posible enlace, y decir cuánto está de acuerdo con ese enlace. 

¿Con quién contamos para hacer esta tarea? Podemos seleccionar un grupo muy selecto de anotadores de muy buena calidad (lo que normalmente será costoso y representará un cuello de botella en nuestro proceso) o podemos dejar que estas tareas las realicen muchísimos anotadores, quizás de menor calidad, pero en mayor cantidad (lo que normalmente será menos costoso).

Podríais pensar que cualquiera nos podría engañar si utilizamos el segundo de los casos. Por supuesto, y los anotadores de mala calidad son muy habituales en este tipo de contextos basados en micro-tareas, pero para ello contamos con la posibilidad de establecer un conjunto de preguntas de control en el proceso (preguntas que no se pueden fallar, y que si se fallan hacen que un anotador quede automáticamente descalificado) y además asignaremos la misma tarea a varios anotadores, por lo que si varios anotadores coinciden en el mismo juicio podemos suponer que los resultados son adecuados. 

Creando las tareas en CrowdFlower

Vamos a utilizar la herramienta CrowdFlower para realizar esta tarea de curación de los enlaces que hemos encontrado.

Durante el #OpenDataDay de Madrid grabaremos un vídeo para explicar cómo funciona esta herramienta, y actualizaré esta entrada de blog. Nos vemos mañana enlazando las calles (de Zaragoza y de Madrid).

Enlazando el callejero de Zaragoza con datos.bne.es (3/4)

Este es el tercero del conjunto de posts sobre el proceso de enlazado del callejero de Zaragoza con datos.bne.es. Ahora vamos a hacer la reconciliación de los nombres de las calles con autores, obras y temas procedentes del portal de datos abiertos de la Biblioteca Nacional (http://datos.bne.es/).

Reconciliando con autores, obras y temas de la Biblioteca Nacional

El portal de datos abiertos de la Biblioteca Nacional contiene una gran cantidad de información sobre autores, obras y temas, todos los cuales están disponibles para ser consultados a través de un portal Web muy sencillo (como se puede ver en la figura, donde estamos buscando información de Cervantes), así como utilizando tecnologías de Linked Data.
En todo momento se puede decidir si se busca y navega por autores, obras o temas, que son los tres tipos de recursos principales que se consideran en este repositorio de datos. 

Accediendo a la información de un autor

Si seleccionamos la primera opción para Cervantes (que claramente representa al Miguel de Cervantes en el que todos estamos pensando), obtendremos la página de descripción de este prolífico autor de la literatura española.
Para nuestros propósitos hay algo importante en lo que nos podemos fijar, que es la URL que aparece en nuestro navegador (http://datos.bne.es/autor/XX1718747.html), que se corresponde con la página de descripción de Cervantes. 
De aquí se puede obtener el identificador (URI) que se usa dentro de la BNE para referirse a este autor (http://datos.bne.es/autor/XX1718747). Por ejemplo, ¿qué ocurre si añadimos .ttl a esta dirección? Obtendremos los datos que se ven en esta página en formato RDF Turtle (http://datos.bne.es/autor/XX1718747.ttl)

Realizando búsquedas de autores

Asimismo, también podemos invocar un servicio para realizar búsquedas de autores. Esto se consigue con consultas como la siguiente:
En esta consulta estamos buscando elementos de tipo Autor que contengan la palabra CERVANTES y obtenemos los resultados en formato JSON.

A continuación tenemos un ejemplo del resultado que se obtiene:

Para Cervantes podemos ver que tenemos 418 hits, ordenados según su ranking de puntuación (que indica cómo de importante es el recurso encontrado). El primer resultado (hit) se refiere a Miguel de Cervantes Saavedra, y de este recurso obtenemos información como su URI, nombre, una descripción, fechas de nacimiento y muerte, etc. Este es uno de los servicios que utilizaremos a continuación.

Buscando obras y temas

De la misma manera en que buscamos autores, podemos buscar obras y temas. Por ejemplo, para obtener las obras en las que aparece la palabra Cervantes (por ejemplo, porque tratan de la vida y obra de este autor), utilizaremos la siguiente llamada:

Y para obtener los temas en los que aparece la palabra Cervantes utilizaremos una llamada parecida:

Ya estamos en disposición de comenzar con las reconciliaciones.

Comenzando a reconciliar con Open Refine

Teniendo en cuenta que los servicios de búsqueda anteriormente mencionados no ofrecen sus datos en JSON de acuerdo con el esquema necesario para que se pueda activar el servicio de reconciliación usado por Open Refine, lo que debemos es utilizar la funcionalidad "Add Column by fetching URLs..." que se nos ofrece para cualquier columna. Vamos a utilizar la columna title_ext para nuestro propósito.
Vamos a comenzar primero obteniendo las obras. Para ello, vamos a crear una columna Autores_BNE usando la siguiente expresión:
El "throttle delay" es una buena práctica cuando estamos haciendo este tipo de consultas masivas (se van a lanzar 3478 consultas) para no realizar un ataque de denegación de servicio a este servicio. De esta manera las consultas se van espaciando en el tiempo. Aunque tardemos un poco más, es una buena práctica cuando accedemos a este tipo de servicios y APIs (y en el caso de APIs habitualmente tenemos limitaciones de número de llamadas que podemos realizar). 

Una vez realizado este proceso, hacemos lo mismo con obras y temas, creando las columnas Obras_BNE y Temas_BNE. Nos quedará algo como lo que aparece a continuación:

Filtrando los resultados obtenidos

Después de este proceso ya tenemos unas grandes cantidades de datos en JSON en las columnas Autores_BNE, Obras_BNE y Temas_BNE. Ahora es el momento de filtrar esta información para poder seguir trabajando con ellos. En concreto, lo que nos interesa en primera instancia para luego poder validar adecuadamente los resultados obtenidos es la URI del autor, obra o tema (para poder así visitar la página de la BNE en cualquier momento y comprobar si la relación es correcta), el score que esa entidad tiene (que representa su importancia) y su nombre.

Para ello, debemos crear nuevas columnas basadas en los datos que tenemos. Esto se hace utilizando la funcionalidad "Add Column based on this column...", escribiendo como expresión a utilizar una expresión como la siguiente:
forEach(value.parseJson().hits.hits,h,h._score.toNumber().round()+" "+h._source.id+" "+h._source.label).join(";;;;")

De esta manera crearemos columnas cuyos valores sean del estilo:
93 XX160612 Fosfatos de Bu-Craa (El Aaiún);;;;52 XX131502 Instituto Mixto de Bachillerato "General Alonso" (El Aaiún)

Diviendo las columnas con múltiples valores

Para poder seguir con los siguientes pasos de limpieza de los datos, podemos dividir las columnas con múltiples valores que hemos generado anteriormente, convirtiéndolas en múltiples filas. Para ello utilizamos la opción de "Split multi-valued cells...", y estableciendo como separador la siguiente secuencia de caracteres ;;;;

Como se puede observar, el número de filas ha crecido muchísimo (se ha multiplicado por 10).


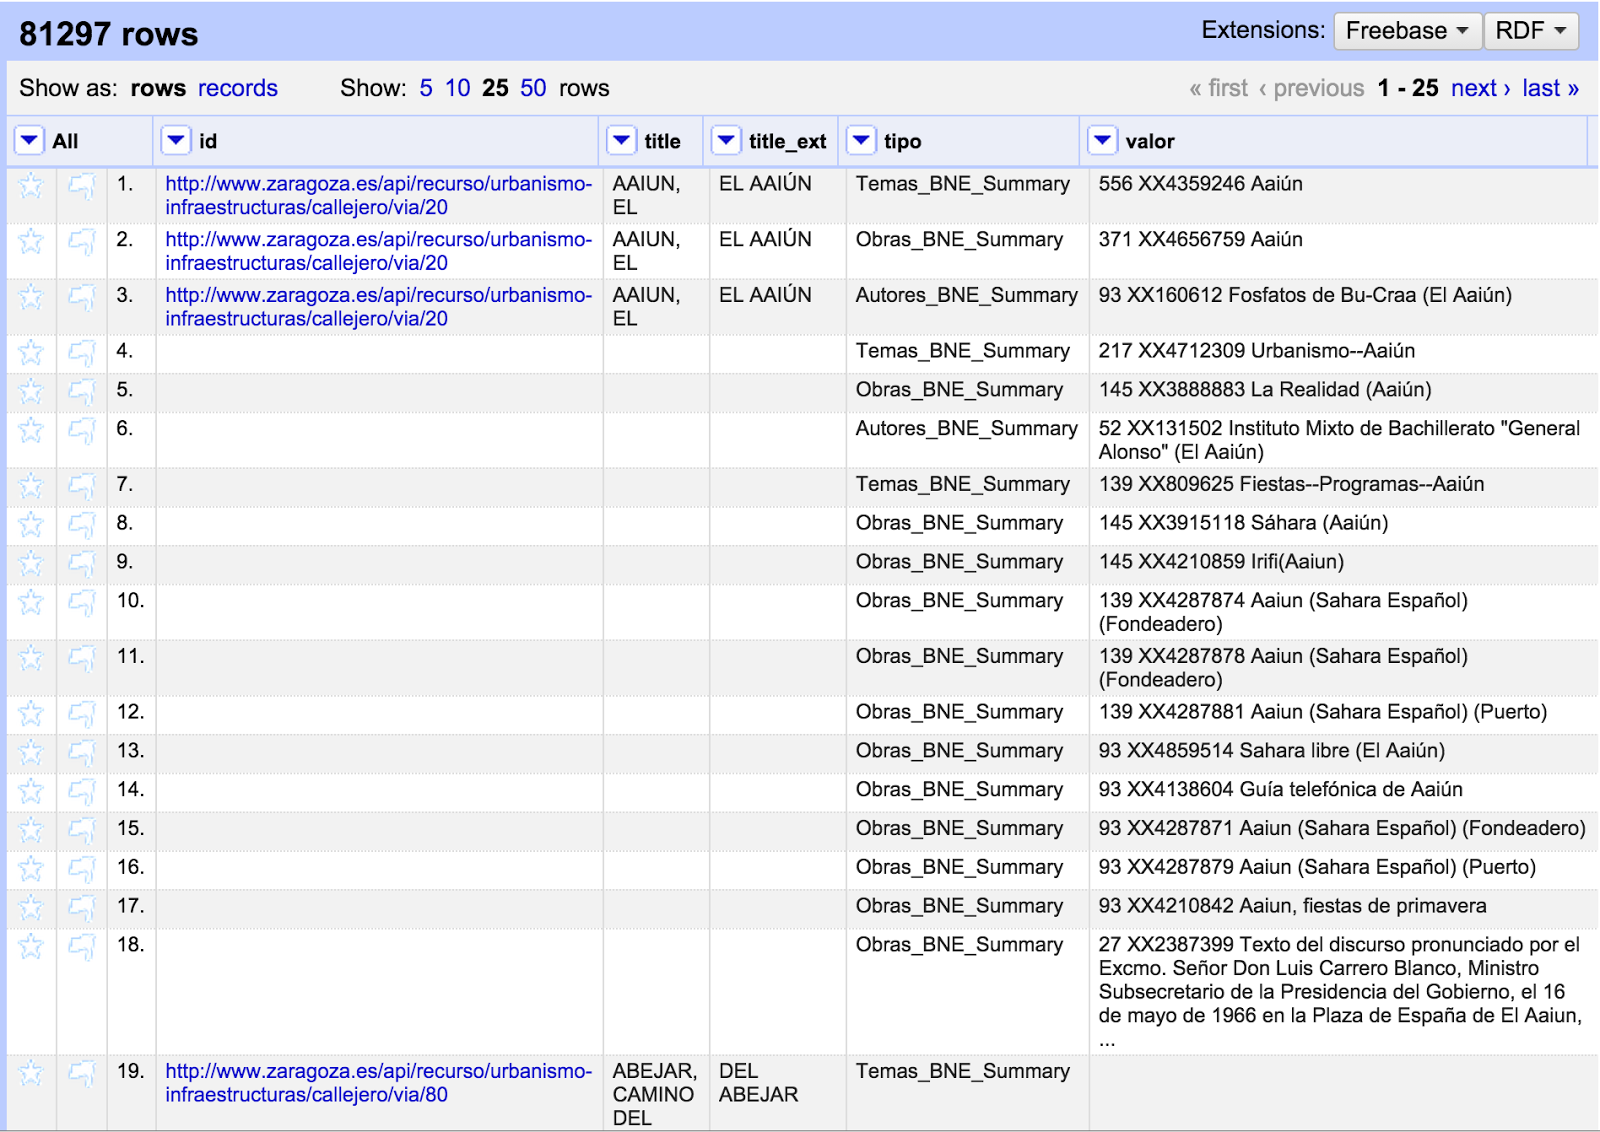
Ahora vamos a realizar una "transposición" de las columnas en filas, con el objetivo de que podamos tratar cada uno de estos valores de uno en uno. Esto se hace utilizando la opción "Transpose cells across columns into rows", seleccionando las tres últimas columnas y denominando a las dos nuevas columnas tipo y valor. El resultado será algo parecido a lo que aparece a continuación:


A continuación conviene rellenar los espacios en blanco que se han generado en las columnas id, title y title_ext para poder trabajar adecuadamente. Esto se hace con la función "Fill Down", y obtendremos una vista similar a la siguiente:

Generando tantas columnas como atributos queremos tratar

Finalmente, dividimos cada columna en varias, para atender a los distintos atributos que hemos ido generando en cada caso. Para ello utilizamos la opción de "Split into several columns...", y renombramos las columnas con los nombres score, idBNE y labelBNE.

Y generamos la URI de BNE creando una nueva columna URI_BNE con la siguiente expresión:
"http://datos.bne.es/"+cells["tipo"].value.toLowercase()+"/"+cells["idBNE"].value

Con todo este procesado, ya tenemos un fichero de 81297 filas donde se relacionan calles con autores, obras y temas. Ahora habrá que validarlo de manera que podamos determinar todos los valores que son adecuados para entender a qué autores están dedicadas nuestras calles, así como con qué obras y temas están relacionadas.

El script completo en Open Refine se encuentra disponible en https://gist.github.com/ocorcho/ce3954b766a0c1651c7b


Enlazando el callejero de Zaragoza con datos.bne.es (2/4)

Este es el segundo del conjunto de posts sobre el proceso de enlazado del callejero de Zaragoza con datos.bne.es. Ahora vamos a hacer un tratamiento inicial del fichero CSV que nos hemos descargado de la API de datos abiertos de Zaragoza.

Haciendo un tratamiento inicial del CSV en Open Refine

Para ello, lanzamos Open Refine (uy, se me olvidó decir que había que instalar primero Open Refine en vuestro ordenador, aunque seguro que muchos de los que me seguís ya lo tenéis instalado). Vamos a crear un proyecto en Open Refine, cargando el CSV que hemos descargado anteriormente:

Para los más arriesgados, podéis utilizar directamente la URL que usamos anteriormente para obtener el CSV, como muestro en la figura siguiente:
Una vez cargados los datos, tendremos una pantalla como la siguiente. Ahora es importante seleccionar la codificación de caracteres correcta para que las letras con tilde aparezcan bien, y ya podemos dar nombre a nuestro proyecto. Con el español suelen funcionar bien ISO-8859-1 o UTF-8.
Lo que podemos ya ver es que el id de cada calle es una URI que sigue la Norma Técnica de Interoperabilidad propuesta en el BOE del 4 de marzo del 2013. De hecho, en Zaragoza también se utiliza el vocabulario para la representación de callejeros que se ha propuesto en el contexto de la norma UNE 178301:2015 sobre Open Data y Smart Cities. Podéis encontrar más detalles sobre la norma aquí.

Ahora podemos eliminar las tres columnas de la izquierda, que no aportan mucho, y ya tenemos el conjunto de datos preparado para la siguiente fase (tratar con las 3478 calles de Zaragoza).


Enlazando el callejero de Zaragoza con datos.bne.es (1/4)

Hacía mucho tiempo que tenía ganas de escribir este conjunto de posts, porque es un trabajo que he estado realizando durante algún tiempo. Y el catalizador ha sido la propuesta del proyecto A quién dedica las calles Madrid, por Antonio Delgado, con motivo del Hackaton del Open Data Day de Madrid del 2015.

Este conjunto de posts está dividido en varios pasos (una entrada por cada uno de ellos):


Así que ya podemos empezar...

Obteniendo el fichero de calles de Zaragoza

En primer lugar, vamos a recopilar todos los nombres de calles de Zaragoza, junto con sus identificadores. Accedemos al catálogo de datos del portal de datos abiertos de Zaragoza, y buscamos el callejero en su buscador:
El callejero está disponible en distintos formatos (PDF, DWG, XML, Excel, CSV, JSON, SOAP). Además, el callejero también está disponible en la API de datos de Zaragoza, así que hay para todos los gustos. Como a mí me encanta usar APIs, os cuento cómo descargarse un CSV con todas las calles de Zaragoza.

Una vez en la página que describe la API de datos de Zaragoza (para los freaks, ya veréis que es Swagger), podemos seleccionar la opción de Callejero, como se muestra a continuación:

Luego, nos vamos a la primera de las opciones, y podremos ver cómo funciona la API cuando hacemos una consulta a la URL http://www.zaragoza.es/api/recurso/urbanismo-infraestructuras/callejero/via. Por defecto, nos mostrará sólo 50 filas, y en formato JSON. 

Vamos a descargarnos un CSV, y a descargarnos todas las filas (como no creo que haya más de 5000 calles, le pongo como parámetro 5000).
En principio, se debería ir haciendo de poquito en poquito, y se puede automatizar con un script, pero eso os lo cuento otro día.

Y ya tenemos el CSV con el que vamos a trabajar. Si no lo has podido conseguir, escríbeme y vemos dónde nos hemos quedado.


viernes, 6 de diciembre de 2013

Data Journalism. A few midnight words

Now that we approach the next hands-on session on data journalism that will be hosted by MediaLab-Prado, and whose agenda is here, I am reading a bit more about data journalism. In fact, I have just come across another blog post on a data journalism event that happened in Venezuela recently, and I have found a very interesting presentation from my good colleague and friend María Esther Vidal. Worth a visit, as usual...
For those of you who are close to Madrid next weekend, come around and enjoy the good atmosphere that we will have over this couple of days.

sábado, 19 de enero de 2013

CIOs, CTOs y su función en la Administración Pública en España

Para variar un poco, este post lo haré en español, debido a que el tema que trato tiene mucho que ver con algunas noticias que se han generado en España, y que supongo que quedarán eclipsadas durante algún tiempo por los grandes casos de corrupción que están surgiendo (rdfs:seeAlso http://politica.elpais.com/politica/2013/01/18/actualidad/1358543329_253168.html).

Recientemente he leído que el cuerpo de informáticos del Estado, al cual pertenecen muchas personas que conozco, incluidos antiguos compañeros míos de carrera, han solicitado, a través de su asociación profesional ASTIC, que se cree en España la figura del jefe nacional de tecnología (CIO - Chief Information Officer). Aquí están algunas de las fuentes que he leído: http://www.astic.es/noticias/propuestas-de-astic-la-comision-de-reforma-de-las-aapp, http://www.cincodias.com/articulo/empresas/informaticos-estado-reclaman-rajoy-jefe-nacional-tecnologia/20130111cdscdsemp_21/.

No puedo estar más de acuerdo con esta solicitud, y con el profundo análisis que se hace en el informe que ha propuesto ASTIC, en el que se detallan las competencias que la figura del CIO debería tener, y espero que este informe sea tenido en cuenta por el Gobierno.

Concretamente, me quedo con uno de los párrafos que aparecen en este informe:
"Esto conducirá a una gestión común y centralizada de los recursos, sobre modelos de procesos y de datos únicos y compartidos, que serán provistos a cada Ministerio para el desempeño de sus misiones específicas"
Y he de reiterar de nuevo que estoy completamente de acuerdo con esta propuesta, pues es algo que ya venimos diciendo muchos desde hace mucho tiempo al hilo de los movimientos que se están produciendo internacionalmente en muchos países sobre la reutilización de la información pública (podéis ver aquí una entrevista reciente a Asunción Gómez-Pérez y a mí para datos.gob.es, en la que precisamente hablábamos de muchos de los pasos que quedan por hacer en el contexto de los datos abiertos en España).

Espero que veamos algo de lo expuesto en esta propuesta en las nuevas leyes que surjan para la reforma de la Administración Pública en España (yo ya he mandado mis propuestas, aunque la verdad es que el formulario Web1.0 que se ha elegido en esta ocasión para esta recogida de propuestas de los ciudadanos ha dejado mucho que desear).
Enhanced by Zemanta

lunes, 12 de noviembre de 2012

A summary of the SSN2012 Workshop


Today we have had a whole day workshop at the ISWC2012 conference on the topic of Semantic Sensor Networks. It is already the 5th workshop that has been held in this area in the last years, and was at the core of the decision of starting a W3C incubator group on Semantic Sensor Networks, in which I participated with another OEGer, Raúl García, which produced interesting results like the SSN Ontology and a semantic markup proposal for sensor data.

Before you start asking where the papers are, you can get them from CEUR proceedings Vol 904, and several of the presentations will be made available in around two weeks at Videolectures. And also before I forget, the work done by Kerry Taylor and Cory Henson on the organisation of the workshop has been great (great people to work with).

And I will start with the invited talk by David de Roure, even if this came in the end of the workshop, talking about the relationship between semantic sensor networks, science, social aspects and..., music... Some interesting projects in this area could be the Semantic Media Network or Social Machines.

David presented some examples of work that he has been involved in. For instance, the Linked Data repositories generated in the SALAMI project, related to the area of music information retrieval. And obviously referred to workflows (e.g., a paper titled Reuse, Remix, Repeat: the Workflows of MIR), so as to deal with the relationship between data and methods to deal with such data, and to ensure reproducibility, reuse and sharing. And from there to Research Objects, such as those defined in the Wf4Ever project.

On the social area, and how this can help music, Dave presented how a crowdsourcing approach can be useful to obtain data from old music scores.

As a summary Dave presented two case studies: one on ICT-enabled manufacturing, where sensors can be used throughout the whole production process, and where data can also come from discourse in collaborative engineering processes; and the another one on end-to-end semantics in the music production and consumption process, from instruments (acting as sensors) to the music consumers, with the scores and MP3 files acting as important parts of the aforementioned Research Objects.

A final set of comments:

  • Do we have examples of end-to-end semantics in SSN?
  • How do we share the methods for processing sensor data? Provenance, trust, reproducibility
  • Are we considering SSN as sociotechnical systems? what are our social objects in SSN, what is the social life of objects, can we use sensors as citizens, what are the social machines in SSN?
  • What can we do in concert with science and music?
  • Can we build something similar to Music Information Retrieval to advance the work?


Once I have gone through this inspiring talk, I will try to summarise the main topics discussed during the workshop. My view is that the following topics were the most salient ones:

  • Applications and patterns that use, reuse and extend the SSN Ontology. Much of this work is not only useful for our Semantic Sensor Network community, but also for the ontology engineering community.
  • Technology needed (query and event processing systems, sensor middleware and platforms) to provide support for semantic sensor networks.
  • Characterisation of sensor data streams.

I will now provide some brief descriptions of the main highlights of most of the presentations (please note that they are not in order of presentation, but according to my previous characterisation).

1. Applications and patterns that use, reuse and extend the SSN Ontology


Laurent Lefort, from CSIRO, presented the award-wining (btw, thanks to the SPITFIRE project for sponsoring it) paper A Linked Sensor Data Cube for a 100 Year Homogenised Daily Temperature Dataset, describing the data cubes that have been made available at http://lab.environment.data.gov.au/, reusing the SSN Ontology and the RDF Datacube vocabulary. Many of the problems that he was explaining remind me of the ones that we had when building our http://aemet.linkeddata.es/ site, which used data similar to that used here from the Australian BoM (Bureau of Meteorology) weather stations and which was made available in the now not-so-open AEMET FTP site. Some of these problems are the changes in the sites where weather stations are, the changes in numbers, the sensors, the procedure changes (hours of observations), etc. I recommend checking the mashup. The data is also accesible through the Linked Data API (for example, http://lab.environment.data.gov.au/data/acorn/climate/slice/station). Great work, Laurent, and good discussion during coffee afterwards.

Edna Ruckhaus, from Universidad Simón Bolívar, was presenting some joint work with our Ontology Engineering Group on a case study application with bike sharing systems. The resulting mashup is available at http://transporte.linkeddata.es/. This paper is not only about the description of how the application was built, but also about lessons learned in the process (e.g., difficulties found when extending the SSN Ontology on the treatment of properties). Besides, it showed how R2RML mappings can be used to generate static metadata about sensors, as well as generating data streams, with the same set of mappings.

Rimel Bendadouche, from Irstea, presented the paper Extension of the Semantic Sensor Network Ontology for Wireless Sensor Networks: The Stimulus-WSNnode-Communication Pattern, focused on the topic of flood modelling. Everybody in the audience agreed that this was a nice pattern to consider and that it would be good to have it discussed in the SSN community group.

Mikel Emaldi presented the work behind BizkaiSense (check the paper here), in the context of the Open Data Euskadi initiative, especially focusing on the ontologies that had to be taken and extended from the SWEET suite of ontologies or for units of measurement. Now they are starting to work on solid waste.

Auriol Degbelo, from Münster, presented a data quality extension to the SSN Ontology.

Another interesting sensor registration demo was given by Pramod Anantharam, from Wright State University,

2. Enabling technology


Mikko Rinne, from the Aalto University, presented his paper titled SPARQL-Based Applications for RDF-Encoded Sensor Data. Even if the title may suggest that the presentation would be mainly about applications, Mikko's presentation focused mainly on the implementation of the INSTANS event processing platform, based on SPARQL and the use of the RETE algorithm. Two implementations exist (on SCALA and LISP, yes, that old language that is still being used in many applications, and that according to Mikko is much faster). Following Mikko's presentation, I am really willing to test it (looking forward to having on their website the LISP version available).

Luka Bradesko, from JSI, presented a rule-based framework and tool for acquiring semantic metadata for sensors.

Ruben Verborgh, a PhD student from Ghent University, presented the paper Functional Composition of Sensor Web APIs, describing how sensors, described as REST Web APIs, can be automatically composed with generic reasoners in a short amount of time (a nice example used in the presentation was on looking for a restaurant to have dinner, and sitting outside in case that it will not rain). More information is available at http://restdesc.org/.

Kia Teymourian, from Freie Universität Berlin, presented the paper Semantic Processing of Sensor Event Stream by Using External Knowledge Bases. This work addresses an important aspect of how to enrich data streams with additional external knowledge bases in order to detect events in those data streams, using a description logic reasoner. It showed how SPARQL queries can be intertwined with event processing queries for a more complex event processing that takes into account such external knowledge bases.

3. Sensor data characterisation

Jean Paul Calbimonte, from my research group, presented some joint effort between our group and EPFL on the characterisation of sensor data streams. Starting from the assumption that especially in citizen sensing projects the metadata that is given by data stream owners is usually weak, it may possible to look at the data streams and generate the SSN Ontology-related metadata that is needed in order to understand better the features of interest and properties that these data streams are measuring.


In summary, a very lively workshop with lots of new ideas and the confirmation that the work that the Semantic Sensor Community has done in the past is currently being used. I hope that this summary is useful for my readers, and I hope that next year we will be holding our 6th Workshop. See you in Sydney, home of the ISWC2013 conference.